Used to check for browser translation. 用于检测浏览器翻译。 ブラウザの翻訳を検出する
[
](https://community.arcblock.io/)
没有收到评论里面的表情回复
D Discuss Kit
1次浏览
分类 / 缺陷
Kawa·
an hour ago
A在B的帖子里面评论,C用表情回复A,A没有收到任何表情回复通知
Kawa 发布
1 小时前
2 条评论
Kawa·7 minutes ago
· edited
该评论已被删除
Kawa·4 minutes ago
Normal
[ ](https://community.arcblock.io/)
The official ArcBlock community running on the ArcBlock platform
产品
DID WalletDID SpacesDID NamesBlocklet LauncherBlocklet ServerAIGNE
学习更多
文档博客
公司
官网加入我们关于我们
社区
讨论奖励活动投票
Copyright © 2025 ArcBlock
Terms of ServicePrivacy PolicyService LevelsSite Map
2.4.17
编辑 1 次
Kawa 创建
7 分钟前
(最近)
Kawa 创建 7 分钟前
import random
import jieba
from collections import defaultdict
class ArticleGenerator:
def __init__(self):

    self.word_pairs = defaultdict(list)

    self.vocab = self.load_vocab('chinese_vocab.txt')

def load_vocab(self, file):

    # 加载百万级词库(示例)

    with open(file, 'r', encoding='utf-8') as f:

        return [line.strip() for line in f]

def train(self, text, window=3):

    words = list(jieba.cut(text))

    for i in range(len(words)-window):

        context = tuple(words[i:i+window])

        next_word = words[i+window]

        self.word_pairs[context].append(next_word)

def generate(self, length=5000):

    context = random.choice(list(self.word_pairs.keys()))

    article = list(context)

    for _ in range(length):

        next_word = random.choices(

            self.word_pairs[context],

            weights=self._get_weights(context)

        )[0]

        article.append(next_word)

        context = tuple(article[-len(context):])

    return ''.join(article)

def _get_weights(self, context):

    # 动态权重调整算法

    return [1 + random.uniform(-0.2, 0.2) for _ in self.word_pairs[context]]
generator = ArticleGenerator()
generator.train(open('chinese_corpus.txt', 'r', encoding='utf-8'))
print(generator.generate(5000))import random
def __init__(self):

    self.word_pairs = defaultdict(list)

    self.vocab = self.load_vocab('chinese_vocab.txt')

def load_vocab(self, file):

    # 加载百万级词库(示例)

    with open(file, 'r', encoding='utf-8') as f:

        return [line.strip() for line in f]

def train(self, text, window=3):

    words = list(jieba.cut(text))

    for i in range(len(words)-window):

        context = tuple(words[i:i+window])

        next_word = words[i+window]

        self.word_pairs[context].append(next_word)

def generate(self, length=5000):

    context = random.choice(list(self.word_pairs.keys()))

    article = list(context)

    for _ in range(length):

        next_word = random.choices(

            self.word_pairs[context],

            weights=self._get_weights(cont

        article.append(next_word)我我我我我我我我
2dddd
我我我我我我我我我我我我我ddssssd的的
return ''.ffd的的的的的的的的的的的的的的的的的的的的d的的的的的的的的ddff是的的的的的
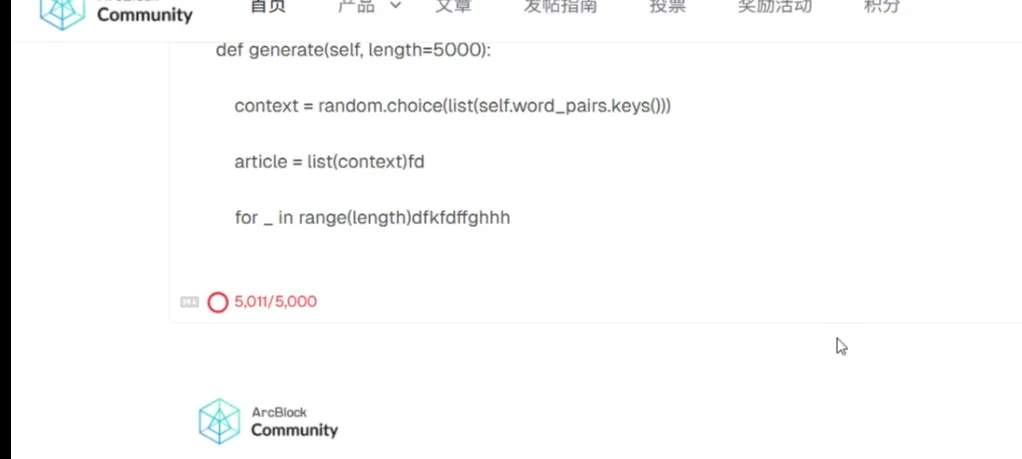
目前看是官方插件存在 bug , 可能会中低优先级处理
Bug: MaxLengthPlugin doesn't work correctly in composite languages · Issue #5102 · facebook/lexical
ok
 KA
4 条回复
Used to check for browser translation. 用于检测浏览器翻译。 ブラウザの翻訳を検出する
[
](https://community.arcblock.io/)
没有收到评论里面的表情回复
D Discuss Kit
1次浏览
分类 / 缺陷
Kawa·
an hour ago
A在B的帖子里面评论,C用表情回复A,A没有收到任何表情回复通知
Kawa 发布
1 小时前
2 条评论
Kawa·7 minutes ago
· edited
该评论已被删除
Kawa·4 minutes ago
· edited
该评论已被删除
Normal
[ ](https://community.arcblock.io/)
The official ArcBlock community running on the ArcBlock platform
产品
DID WalletDID SpacesDID NamesBlocklet LauncherBlocklet ServerAIGNE
学习更多
文档博客
公司
官网加入我们关于我们
社区
讨论奖励活动投票
Copyright © 2025 ArcBlock
Terms of ServicePrivacy PolicyService LevelsSite Map
2.4.17
编辑 1 次
Kawa 创建
7 分钟前
(最近)
Kawa 创建 7 分钟前
import random
import jieba
from collections import defaultdict
class ArticleGenerator:
使用示例
generator = ArticleGenerator()
generator.train(open('chinese_corpus.txt', 'r', encoding='utf-8'))
print(generator.generate(5000))import random
import jieba
from collections import defaultdict
class ArticleGenerator:
使用示例
generator = ArticleGenerator()
generator.train(open('chinese_corpus.txt', 'r', encoding='utf-8'))
print(generator.generate(5000))import random
import jieba
from collections import defaultdict
class ArticleGenerator:
-
2dddd
我我我我我我我我我我我我我ddssssd的的
目前看是官方插件存在 bug , 可能会中低优先级处理
Bug: MaxLengthPlugin doesn't work correctly in composite languages · Issue #5102 · facebook/lexical
ok